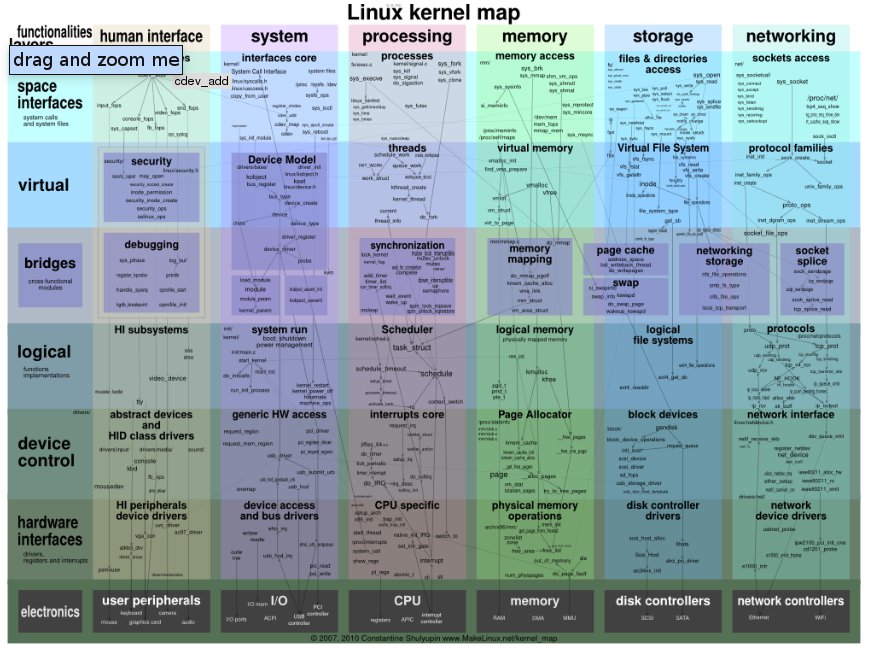
Leo en esta entrada de muylinux sobre la existencia de un mapa interactivo del kernel de linux:
http://www.muylinux.com/2011/01/17/sumergete-en-el-kernel-2-6-36-con-su-mapa-interactivo/comment-page-1/#comment-47256.
El link directo al mapa: http://www.makelinux.net/kernel_map.shtml
Y para muestra un botón:
¡¡Impresionante!!
Showing posts with label linux. Show all posts
Monday, January 17, 2011
Monday, November 24, 2008
Clonar una Red Hat Enterprise Linux (RHEL 5.0)
El viernes me pidieron hacer un clon de una máquina en explotación y que bajo ningún concepto podía reiniciarse ni verse afectada en su rendimiento.
La petición concreta fue la de obtener una copia exacta de la RHEL en explotación sobre un hardware muy parecido.
Se valoraron dos opciones, ambas empiezan por arrancar el clon con una LiveCd:
Optamos por la segunda pero entonces una actualización del firmware de la placa base y de la scsi hizo que ninguna LiveCd arrancase sobre la máquina. Así que sobre la partición correspondiente al /home original instalamos un ubuntu 8.10 server como minimal, sobre el que se instaló el cliente del programa de backup (legato networker).
Una vez recuperado, configuré el grub propio de la ubuntu para arrancar la RHEL, pero... daba un error ... bueno dos:
* se quejaba de no encontrar la etiqueta de la partición de swap
* daba un error muy breve de algo del /dev/console y se reiniciaba
Para solucionar el primer problema:
# desmontamos la partición de swap
$>swapoff
# ejecutamos mkswap
$>mkswap -L <etiqueta> /dev/sda5
Para solucionar el segundo problema:
En las distribuciones basadas en debian, los devices (/etc/dev) se crean cada vez que el equipo arranca. Sin embargo, las RHEL y los solaris no. En RHEL deben crearse:
$>/sbin/start_udev
y tira millas!! con start_udev recreamos los devices del /dev
Y con esto el equipo vuelve a arrancar.
Antes de despedirme ... la máquina en cuestión tiene 16 procesadores, 24 GB de ram, un mirror SCSI donde está el sistema, y los datos en dos luns de la SAN de más de un tera cada uno ... es que se me pone dura sólo de pensarlo.
Buenas noches.
La petición concreta fue la de obtener una copia exacta de la RHEL en explotación sobre un hardware muy parecido.
Se valoraron dos opciones, ambas empiezan por arrancar el clon con una LiveCd:
- copiar todos los ficheros de la máquina por scp, gracias al uso del phreakietar que algún día postearé.
- instalar un cliente de nuestro programa de backup sobre la LiveCd y realizar una recuperación del otro servidor sobre el clon, y luego cambiar la ip y el nombre de máquina, así como otras configuraciones menores.
Optamos por la segunda pero entonces una actualización del firmware de la placa base y de la scsi hizo que ninguna LiveCd arrancase sobre la máquina. Así que sobre la partición correspondiente al /home original instalamos un ubuntu 8.10 server como minimal, sobre el que se instaló el cliente del programa de backup (legato networker).
Una vez recuperado, configuré el grub propio de la ubuntu para arrancar la RHEL, pero... daba un error ... bueno dos:
* se quejaba de no encontrar la etiqueta de la partición de swap
* daba un error muy breve de algo del /dev/console y se reiniciaba
Para solucionar el primer problema:
# desmontamos la partición de swap
$>swapoff
# ejecutamos mkswap
$>mkswap -L <etiqueta> /dev/sda5
Para solucionar el segundo problema:
En las distribuciones basadas en debian, los devices (/etc/dev) se crean cada vez que el equipo arranca. Sin embargo, las RHEL y los solaris no. En RHEL deben crearse:
$>/sbin/start_udev
y tira millas!! con start_udev recreamos los devices del /dev
Y con esto el equipo vuelve a arrancar.
Antes de despedirme ... la máquina en cuestión tiene 16 procesadores, 24 GB de ram, un mirror SCSI donde está el sistema, y los datos en dos luns de la SAN de más de un tera cada uno ... es que se me pone dura sólo de pensarlo.
Buenas noches.
Tuesday, November 18, 2008
Fijar la zona horaria (time zone) en LINUX
La zona horaria marca el desfase en horas con respecto al GMT (meridiano de Greenwitch). Gracias a que el sistema conoce su zona horaria nos basta con un único servidor ntp para que varios sistemas sepan que tienen la misma hora a pesar de que su reloj marque números diferentes... Vaya, que forma más difícil de decirlo. Gracias a que un equipo sabe en qué zona horaria está, sabe que la hora de Madrid es la del GMT + 1, y por eso puede sincronizarse con otros equipos del mundo.
Basta de rollo:
Para saber la Time Zone de un equipo:
ls -l /etc/localtime
lrwxrwxrwx 1 root root 33 2006-11-27 11:43 /etc/localtime - > /usr/share/zoneinfo/Europe/London
Para cambiarla a Madrid:
ln -sf /usr/share/zoneinfo/Europe/Madrid /etc/localtime
Basta de rollo:
Para saber la Time Zone de un equipo:
ls -l /etc/localtime
lrwxrwxrwx 1 root root 33 2006-11-27 11:43 /etc/localtime - > /usr/share/zoneinfo/Europe/London
Para cambiarla a Madrid:
ln -sf /usr/share/zoneinfo/Europe/Madrid /etc/localtime
Tuesday, October 21, 2008
dos2unix | sed | awk > salida.txt
Se trata de parsear el visor de sucesos de un Windows para buscar un tipo de ocurrencia o suceso.
Para los impacientes, seré breve:
Ir al visor de sucesos (event viewer), clic dcho en security, guardar como, elegir texto tabulado (tab). En nuestro caso, el fichero se llama jl2.txt. Copiarlo a tu máquina con tu flamante linux y a continuación ejecutar:
y ya tienes todo el registro con una línea por entrada, y podeis empezar con los grep, egrep, ... que os vengan en gana.
La historia completa:
A raiz de un incidente de seguridad, me tocó repasar el event viewer del W2003 del repositorio de ficheros. Seguro que hay otras formas de hacerlo, pero un gran técnico (y un gran jefe, dicho sea de paso) me dió todo un recital de shell scripting tradicional-flauvored.
Así que aunque puede que no conduzca a ninguna parte, allí va. En algunas carpetas delicadas del repositorio alguna usuaria había detectado de cuando en cuando que faltaban contenidos que recuperábamos del backup (con un poco de suerte no había que mandar traer la cinta, ...). Por esto hace un año auditamos los accesos, cambios, ... de todo el contenido de esas carpetas. Esto genera un registro de seguridad gigante, unos 500Mb por semana. A veces hay más de 20 entradas por segundo.
Para parsear todo ese meollo, y llegar a los registros que nos interesan pensamos en exportar el registro de seguridad (Event Viewer - Security), pero la información que proporciona es menor que la del visor de eventos, y la necesitábamos toda.
Finalmente, nos acordamos que si en lugar de exportar haces un guardar como entonces sí que obtienes toda la información que ves desde el visor de sucesos. Puedes sacarlos como texto tabulado, o como csv. Este último formato no es fiable al pasarlo a una hoja de cálculo, ya que encontramos divergencias importantes. Así que nos quedamos con el tabulado.
Pero al guardarlo así, no muestra un registro por línea, y nuestro grep no es muy útil. Además los registros no tienen todos el mismo formato. Por eso buscamos una forma de meterlo cada evento en 1 línea (larga, pero eso no importa), y así luego hacer grep sobre el fichero y extraerlo los DELETE sobre el path deseado.
Para los impacientes, seré breve:
Ir al visor de sucesos (event viewer), clic dcho en security, guardar como, elegir texto tabulado (tab). En nuestro caso, el fichero se llama jl2.txt. Copiarlo a tu máquina con tu flamante linux y a continuación ejecutar:
dos2unix -b jl2.txt
sed 's/\t/;/g' jl2.txt | awk '$1 ~ /^"$/{printf "\n\n"} $1 !~ /^"$/{printf "%s",$0}' > log_G_repo.txt
y ya tienes todo el registro con una línea por entrada, y podeis empezar con los grep, egrep, ... que os vengan en gana.
La historia completa:
A raiz de un incidente de seguridad, me tocó repasar el event viewer del W2003 del repositorio de ficheros. Seguro que hay otras formas de hacerlo, pero un gran técnico (y un gran jefe, dicho sea de paso) me dió todo un recital de shell scripting tradicional-flauvored.
Así que aunque puede que no conduzca a ninguna parte, allí va. En algunas carpetas delicadas del repositorio alguna usuaria había detectado de cuando en cuando que faltaban contenidos que recuperábamos del backup (con un poco de suerte no había que mandar traer la cinta, ...). Por esto hace un año auditamos los accesos, cambios, ... de todo el contenido de esas carpetas. Esto genera un registro de seguridad gigante, unos 500Mb por semana. A veces hay más de 20 entradas por segundo.
Para parsear todo ese meollo, y llegar a los registros que nos interesan pensamos en exportar el registro de seguridad (Event Viewer - Security), pero la información que proporciona es menor que la del visor de eventos, y la necesitábamos toda.
Finalmente, nos acordamos que si en lugar de exportar haces un guardar como entonces sí que obtienes toda la información que ves desde el visor de sucesos. Puedes sacarlos como texto tabulado, o como csv. Este último formato no es fiable al pasarlo a una hoja de cálculo, ya que encontramos divergencias importantes. Así que nos quedamos con el tabulado.
Pero al guardarlo así, no muestra un registro por línea, y nuestro grep no es muy útil. Además los registros no tienen todos el mismo formato. Por eso buscamos una forma de meterlo cada evento en 1 línea (larga, pero eso no importa), y así luego hacer grep sobre el fichero y extraerlo los DELETE sobre el path deseado.
Monday, October 20, 2008
The WATCH
Hay dias de pena en que aprendemos algo que hace que ese día sea un poquito mejor. Y eso ha sido una pequeña instrucción *nix (linux en mi caso), que realmente me ha gustado.
Prueba a procesar a base de awk, grep, ... un fichero de 400Mb de txt ... En seguida andas desde otro terminal haciendo:
para ver como va creciendo el ficherito. Pues ahora podemos hacerlo así:
y cada segundo que pasa nos va enseñando la salida de ls -lh , actualizando el tamaño del fichero.
y con esto y un bizcocho ...
Prueba a procesar a base de awk, grep, ... un fichero de 400Mb de txt ... En seguida andas desde otro terminal haciendo:
ls -lh <mi_ficherito_de_4TB.txt>
para ver como va creciendo el ficherito. Pues ahora podemos hacerlo así:
watch -n 1 ls -lh <mi_ficherito_de_4TB.txt>
y cada segundo que pasa nos va enseñando la salida de ls -lh , actualizando el tamaño del fichero.
y con esto y un bizcocho ...
y finalmente empezé
Muchas veces me he dicho, si tuviese un blog esto lo recogería. Finalmente me he decidido, como son las tantas no voy a decir de dónde sale el nombre, pero al tiempo ... porque la instrucción que da nombre a este blog tiene narices.
Así copié un DVD de mi hija, para salvar el original de sus zarpas y dejar que practique con la copia el mete-saca, para-arranca.
Uso Ubuntu Hardy, con los repositorios estándar de Ubuntu. He instalado el k9copy pero fallaba al hacer la copia. Faltaba dos paquetes: libdvdcss libdvdcss2 que están disponibles en el repositorio de medibuntu. Aquí hay un link fantástico sobre cómo hacerlo:
http://www.zaphu.com/2008/05/31/ubuntu-guide-ripping-and-burning-dvds-with-k9copy-and-brasero/
Un comentario sobre el link que hace a la instalación de los paquetes desde medibuntu (http://www.zaphu.com/2008/05/30/ubuntu-guide-installing-media-codecs-for-flash-dvd-quicktime-mov-mp3-wmv-wma-and-acc-mp4-m4a-playback/):
si substituyes aptitude install libdvdcss libdvdcss2
por : apt-get install libdvdcss libdvdcss2
revienta vivo. La verdad que como soy un ignorante del aptitude, pues no sé si es normal o no.
Por ahora sólo lo señalo.
Buenas noches yo.
Subscribe to:
Posts (Atom)
